Alibaba’nın Qwen ekibi, Qwen4-Max modelini 16 Kasım 2026’da genel kullanıma açtı. Model; QwenCloud API, Token Plan, Qwen Studio, QwenWork ve Qoder üzerinden kullanılabiliyor. 11 Kasım’da sunulan qwen4-max-preview sürümü yalnızca Token Plan kapsamında erişilebilirken, yeni qwen4-max modeli ödedikçe kullanıma da açıldı. Bu nedenle duyuru, yalnızca modelin yeni sürümünü değil, geliştiricilerin modele hangi kanallardan ve hangi fiyatlandırmayla ulaşabileceğini de kapsıyor.
Qwen ekibi duyuruyu X hesabında paylaştı: https://twitter.com/Alibaba_Qwen/status/2122148127520289151. Ekibin verdiği bilgilere göre model yeni Qwen4 mimarisi üzerine kurulu. Modelin toplam omurga parametre sayısı 2,4 trilyon; her token işlenirken etkinleşen parametre sayısı ise 71 milyar. Bunlara ek olarak 328 milyar N-gram Embedding parametresi bulunuyor. Qwen ayrıca yerel görme yeteneği ve bir milyon tokenlık bağlam penceresi bildiriyor. Bu özellikler, modelin uzun metinlerle ve görsel girdilerle çalışmasını hedefliyor; ancak gerçek performans, kullanılan görev ve ayarlara göre değişebilir.
Fiyatlandırma ve kullanım seçenekleri
Qwen4-Max’in öne çıkan yönlerinden biri, API üzerinden ödedikçe kullanıma açılması ve önceki modelle karşılaştırıldığında daha düşük liste fiyatı sunması. Alibaba Cloud Model Studio fiyat tablosunda Singapur bölgesi için qwen4-max’in fiyatı milyon girdi tokenı başına 1,5 dolar, milyon çıktı tokenı başına 4,5 dolar olarak listeleniyor. Aynı tabloda Qwen3.8-Max için bu ücretler sırasıyla 2 dolar ve 6 dolar. Bu karşılaştırmaya göre yeni modelin standart girdi ve çıktı fiyatları %25 daha düşük.
Önbellek kullanımı maliyeti ayrıca etkileyebilir. Qwen’in fiyat tablosunda örtük önbellekten okuma, milyon token başına 0,075 dolar. Şirket, bu ücretin Qwen3.8-Max’e kıyasla %70 daha düşük olduğunu belirtiyor. Açık önbellek yazımı için beş dakikalık seçenekte milyon token başına 1,875 dolar, bir saatlik seçenekte 3 dolar ücret veriliyor; okuma ücreti ise 0,075 dolar olarak kalıyor. Bu tarifeler bölgeye ve ürün koşullarına göre değişebileceğinden, üretim ortamına geçmeden önce güncel fiyat tablosunu kontrol etmek gerekir.
Qwen’in Work360 adlı iç değerlendirmesinde görev başına ortalama maliyetin 4,43 dolardan 1,67 dolara indiği bildiriliyor. Bu, şirketin ölçümünde yaklaşık %62 düşüş anlamına geliyor. X paylaşımında sonuç, “%50’ye kadar daha az token” ve “görev maliyetinde %60’ın üzerinde düşüş” ifadeleriyle özetlenmiş. Bu rakamlar Qwen’in kendi testlerine dayanıyor; farklı istemler, çıktı uzunlukları, düşünme ayarları ve önbellek kullanımı gerçek maliyeti değiştirebilir.
Mimari, bağlam ve model yetenekleri
Qwen4-Max, uzmanların karışımı (mixture-of-experts, MoE) yaklaşımını kullanan bir model. Qwen, yeni mimaride uzun metin içinde ilgili bilgiyi bulma, katmanlar arasında bilgi aktarımı ve sözcüklerin temsili gibi bileşenleri yenilediğini söylüyor. Şirketin hedefi, uzun bağlamlı görevlerde daha hızlı ve daha düşük maliyetli işlem sağlamak. MoE yapısında toplam parametre sayısı ile her token için etkinleşen parametre sayısı aynı değildir; açıklanan 2,4 trilyon omurga parametresi toplam ölçeği, 71 milyar etkin parametre ise token işleme sırasında kullanılan kısmı ifade eder.
QwenCloud belgelerine göre düşünme kapalı olduğunda azami çıktı uzunluğu 131.072 token. Düşünme açıkken modelin düşünme içeriğiyle son yanıtının toplamı 262.144 token’a kadar çıkabiliyor. Varsayılan düşünme bütçesi 131.072 token olarak belirtilmiş. Model varsayılan olarak düşünme modunda yanıt veriyor ve API’deki varsayılan çaba düzeyi “high”, yani en yüksek kademe. Geliştiriciler bu çaba düzeyini düşürebilir. Daha yüksek düşünme bütçesi bazı karmaşık görevlerde yararlı olabilir; bununla birlikte yanıt süresini ve token tüketimini artırabileceği için kullanım senaryosuna göre ayarlanmalıdır.
Model metin, görüntü ve video girdilerini işleyebiliyor. Belgelerde işlev çağırma (function calling), yapılandırılmış çıktı, web araması, PDF işleme, kod yorumlayıcı ve MCP (Model Context Protocol) desteği de listeleniyor. Buna karşılık ince ayar (fine-tuning), model dağıtımı ve toplu çıkarım (batch inference) desteklenmiyor. Dolayısıyla Qwen4-Max, mevcut ağırlıkları indirip kendi altyapısında eğitmek veya çalıştırmak isteyen ekiplerden çok, yönetilen API ve ürünler üzerinden model kullanmayı tercih eden geliştiricilere yönelik.
Test sonuçları ve bağımsız değerlendirmeler
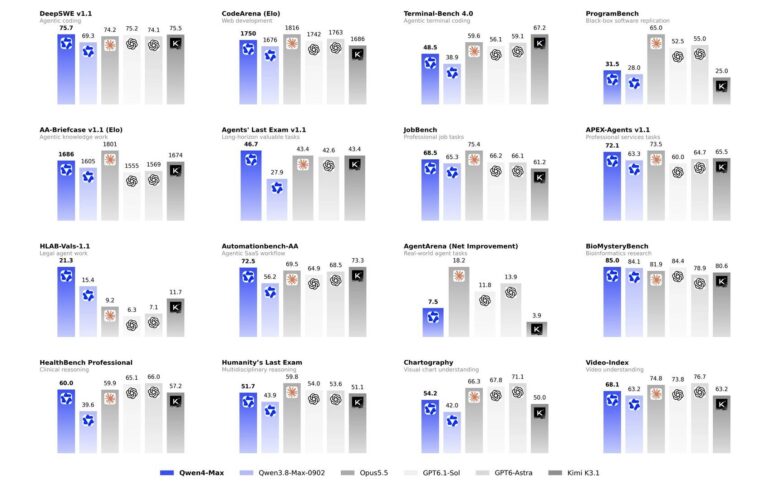
Qwen, karmaşık iş senaryolarını ölçmek için Work360 adlı kendi değerlendirme çerçevesini kullanıyor. Şirketin açıklamasına göre Work360, 26 ana alanı; bunların altında 182 alt alanı ve toplam 721 uzmanlık konusunu kapsıyor. Bu iç testte Qwen4-Max 52,69 puan, Qwen3.8-Max ise 47,74 puan almış. Puanların hangi görev dağılımı ve değerlendirme yöntemiyle elde edildiğini yorumlarken bunun Qwen tarafından oluşturulan ve yürütülen bir test olduğunu göz önünde bulundurmak gerekiyor.
Qwen ayrıca token tüketiminin bazı testlerde düştüğünü bildiriyor. Work360’te Xhigh çaba düzeyinde yaklaşık %24, High düzeyinde yaklaşık %35 daha az token kullanıldığı; Terminal-Bench 4.0’da ise düşüşün sırasıyla yaklaşık %48 ve %49 olduğu belirtiliyor. Bu oranlar, karşılaştırılan model ve ayarlara bağlı şirket test sonuçlarıdır; her istemde aynı tasarrufun sağlanacağı anlamına gelmez.
Bağımsız değerlendirme şirketi Vals AI’nin yayımladığı sonuçlarda Qwen4-Max, Vals Index’te 63,20% doğrulukla 11. sırada gösteriliyor ve listelenen Çin modelleri arasında ilk sırada yer alıyor. Qwen ekibi de kodlama ve finans görevlerinde önceki Qwen3.8-Max 0902 sürümüne kıyasla belirgin ilerleme kaydedildiğini söylüyor. Vals AI sıralaması ile Qwen’in iç testleri farklı değerlendirme düzeneklerine dayandığından, sonuçları doğrudan birbirinin yerine kullanmamak gerekir.
Qwen ekibi aynı gün başka sıralama ve ürün testlerine ilişkin notlar da paylaştı. Ekibin açıklamasına göre model Code Arena WebDev’de altıncı sıraya yükseldi ve Qwen3.8-Max’e göre 74 puanlık artış gösterdi. Agent Arena’da önceki Max modeline kıyasla %7,5 net artış bildirildi ve Alibaba’nın laboratuvar sıralamasında beşinci sırada olduğu belirtildi. Image-to-WebDev Arena’da Qwen4-Max’in 1.674 puanla altıncı, önceki Max sürümünün ise 1.639 puanla daha aşağıda yer aldığı açıklandı. DesignArena sonuçlarında model Python-PPTX kategorisinde dördüncü, Spreadsheet kategorisinde beşinci sırada gösterildi. Modelin OpenRouter’da da kullanıma açıldığı bildirildi. Bu sıralama ve puanlar Qwen ekibinin paylaştığı sonuçlardır; değerlendirme platformlarının yöntemleri ve güncel tabloları zaman içinde değişebilir.
Türkiye’den erişim ve veri konumu
Türkiye’deki geliştiriciler Qwen4-Max’e API üzerinden erişebilir. QwenCloud ve Alibaba Cloud Model Studio belgelerinde Türkiye için yerel bir veri merkezi bölgesi listelenmiyor. Türkiye’den kullanımda yakın seçenekler arasında Frankfurt ve Singapur bulunuyor; diğer belirtilen bölgeler Hong Kong, Tokyo, Pekin ve ABD’nin Virginia bölgesi. API çağrılarının ve saklanan verilerin seçilen bölgedeki sunuculardan geçmesi, yanıt gecikmesini ve veri yerleşimi tercihlerini etkileyebilir. Kişisel veya kurumsal verilerle çalışırken bölge seçimi, saklama koşulları ve geçerli hukuki yükümlülükler ayrıca incelenmelidir.
Alibaba belgelerinde Frankfurt’taki işlemlerin Avrupa Birliği içinde kalmasını sağlayan bir seçenek de yer alıyor. Bu seçenek, veri konumuna ilişkin gereksinimleri olan kurumlar için önem taşıyabilir; ancak tek başına mevzuata uygunluğu garanti etmez. Kurumların kullandıkları hizmetin güncel sözleşme ve veri işleme koşullarını incelemesi gerekir. API; OpenAI Chat Completions, Responses, Anthropic Messages ve DashScope biçimleriyle uyumlu olduğundan, bu arayüzleri kullanan uygulamalara entegrasyon bazı durumlarda daha kolay olabilir. Yine de parametre adları, araç çağırma davranışı ve yanıt biçimleri uygulama bazında doğrulanmalıdır.
Singapur’da ödedikçe kullanım için bir milyon tokenlık ücretsiz kota bulunduğu belirtiliyor. Bu kota Token Plan kredilerinden ayrı. Ücretsiz kullanımın kapsamı, geçerlilik koşulları ve hesabın uygunluğu değişebileceğinden, kayıt sırasında gösterilen güncel şartlar esas alınmalı. Token Plan ise abonelik temelli ayrı bir seçenektir; 11 Kasım’daki önizleme sürümünün yalnızca bu plan üzerinden erişilebilir olması, yeni sürümün API fiyatlandırmasıyla aynı şey değildir.
Açık ağırlıklar ve şirket örnekleri
Qwen4-Max’in kendisi açık ağırlıklı bir model olarak yayımlanmadı. Mevcut bilgilere göre modelin ağırlıkları Hugging Face veya GitHub üzerinden indirilerek yerel sunucuda çalıştırılamıyor. Qwen ekibi, ailedeki daha küçük Qwen4 modellerinin açık ağırlıklarının ileride yayımlanacağını duyurdu; ancak bu modeller için kesin bir tarih veya boyut belirtilmedi. Bu nedenle yerel kurulum, model ağırlıklarına erişim veya kendi verisiyle ince ayar yapmak isteyenlerin, yayımlanacak küçük modellerin koşullarını beklemesi gerekiyor.
Qwen’in blogunda üretim, hukuk, finans ve araştırma laboratuvarlarına yönelik örnekler bulunuyor. SANF ve Pacific Union örneklerinde tek bir programlama görevinin tamamlanma süresinin yaklaşık 475 dakikadan 24 dakikaya indiği, yani yaklaşık %95 azaldığı aktarılıyor. Bu tür örnekler modelin olası kullanım alanlarını gösterebilir; ancak şirket tarafından sunulan vitrin vakaları bağımsız bir performans ölçümü değildir. Açıklanan bilgilerde Türkiye’de Qwen4-Max’i kullanmaya başladığı doğrulanmış bir şirket adı da yer almıyor.
Sık sorulan sorular
Qwen4-Max ücretsiz mi?
Model genel olarak ödedikçe kullanımla ücretlendiriliyor. Singapur için bir milyon tokenlık ücretsiz kota bildiriliyor; bu kota Token Plan’dan ayrı. Kota koşulları ve hesap uygunluğu için hizmet sağlayıcının güncel bilgileri kontrol edilmeli.
11 Kasım’daki önizleme sürümünden farkı nedir?
qwen4-max-preview, 11 Kasım’da yalnızca Token Plan kapsamında sunuldu. Paylaşılan bilgiye göre önizleme dönemi 11 Kasım saat 10.00 ile 25 Kasım saat 24.00 arasında, UTC+8 zaman diliminde planlandı. 16 Kasım’da kullanıma açılan qwen4-max ayrı bir model kimliğine sahip ve ödedikçe kullanım seçeneği de sunuyor. Önizleme ile genel kullanıma açılan sürümün erişim kanalları ve fiyatlandırması bu nedenle aynı değil.
Türkiye’den kullanmak mümkün mü?
Evet. Türkiye’deki kullanıcılar API üzerinden erişebilir. Belgelerde Türkiye’de yerel bir veri merkezi bölgesi bulunmadığı için Frankfurt veya Singapur gibi bölgeler değerlendirilebilir. Bölge seçimi gecikme, veri konumu ve kurum politikaları açısından önem taşıyabilir.
Qwen4-Max’in ağırlıkları indirilebilir mi?
Hayır. Qwen4-Max için açık ağırlık yayını açıklanmış değil; modelin yerel kurulumu ve ince ayarı da desteklenmiyor. Qwen, daha küçük Qwen4 modellerinin ağırlıklarını gelecekte yayımlamayı planladığını söylüyor, ancak tarih vermiyor.
Model her görevde daha ucuz veya daha hızlı mı?
Qwen’in fiyat tablosunda standart token ücretleri önceki modele göre daha düşük. Şirketin testlerinde token tüketimi ve görev maliyeti de gerilemiş. Bununla birlikte gerçek maliyet ve hız; istemin uzunluğuna, çıktı miktarına, düşünme düzeyine, önbellek kullanımına, seçilen bölgeye ve görevin türüne göre değişir. Üretim kullanımından önce kendi iş yükünüzle deneme yapmak en sağlıklı karşılaştırmayı sağlar.